外观
Video-JEPA(V-JEPA)的简洁实现
I-JEPA 在图像块表征之间做预测;V-JEPA 把上下文与目标扩展到视频的时空块 [Bardes et al., 2024]。本节解释时空分块、掩码、位置条件和目标编码器,再实现一个保留这些接口的简化版本。
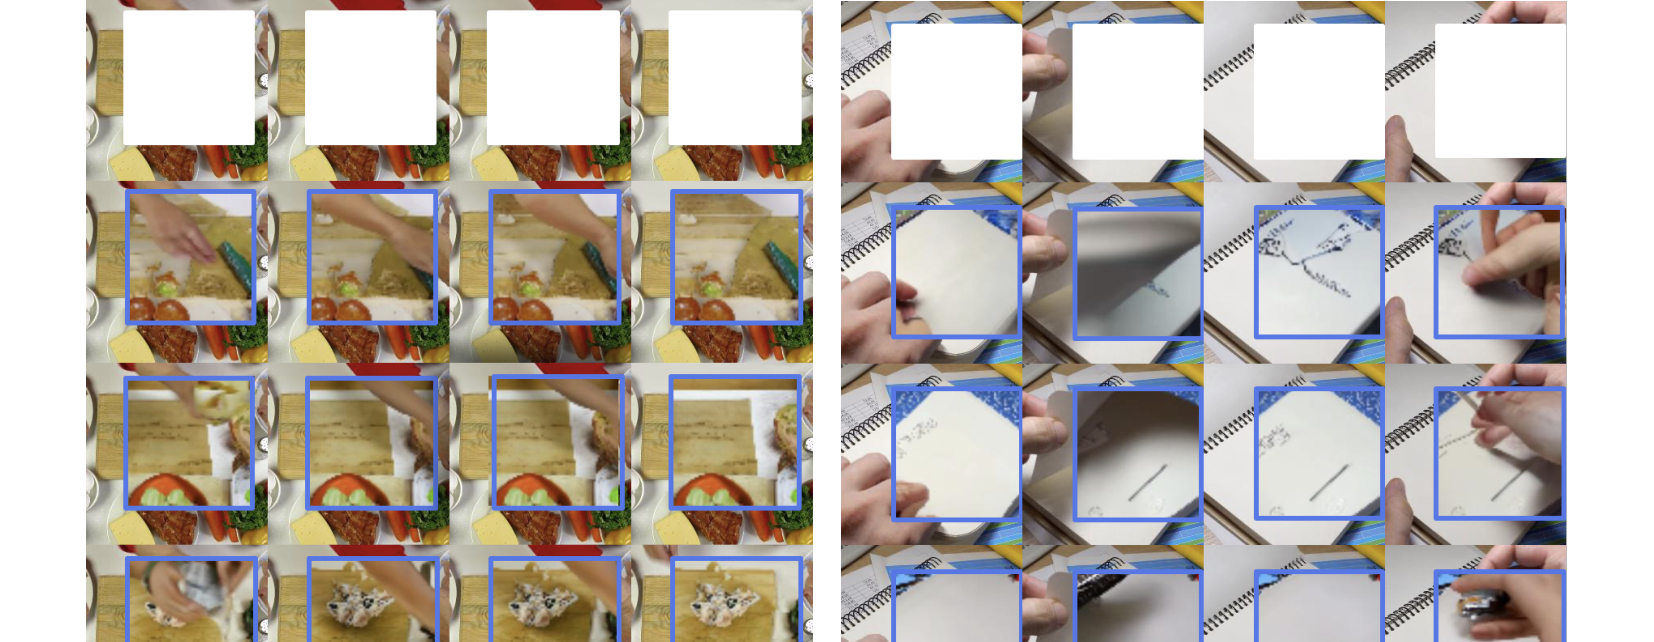
图 6.6-1:V-JEPA 的离线特征预测可视化显示模型从可见视频上下文推断被遮挡区域的语义内容。 出处:Adrien Bardes et al.,Revisiting Feature Prediction for Learning Visual Representations from Video(2024),Figure 6。
历史脉络与学术背景
在深度学习的早期,视频理解大多依赖于 3D 卷积神经网络(如 C3D)或是结合了时间序列模型(如 LSTM)的 2D 卷积网络。随着 Transformer [Vaswani et al., 2017] 在自然语言处理领域的巨大成功,研究者们迅速将其引入到视觉领域。Vision Transformer(ViT)[Dosovitskiy et al., 2020] 证明了将图像切分为块(Patch)并进行自注意力计算的有效性。
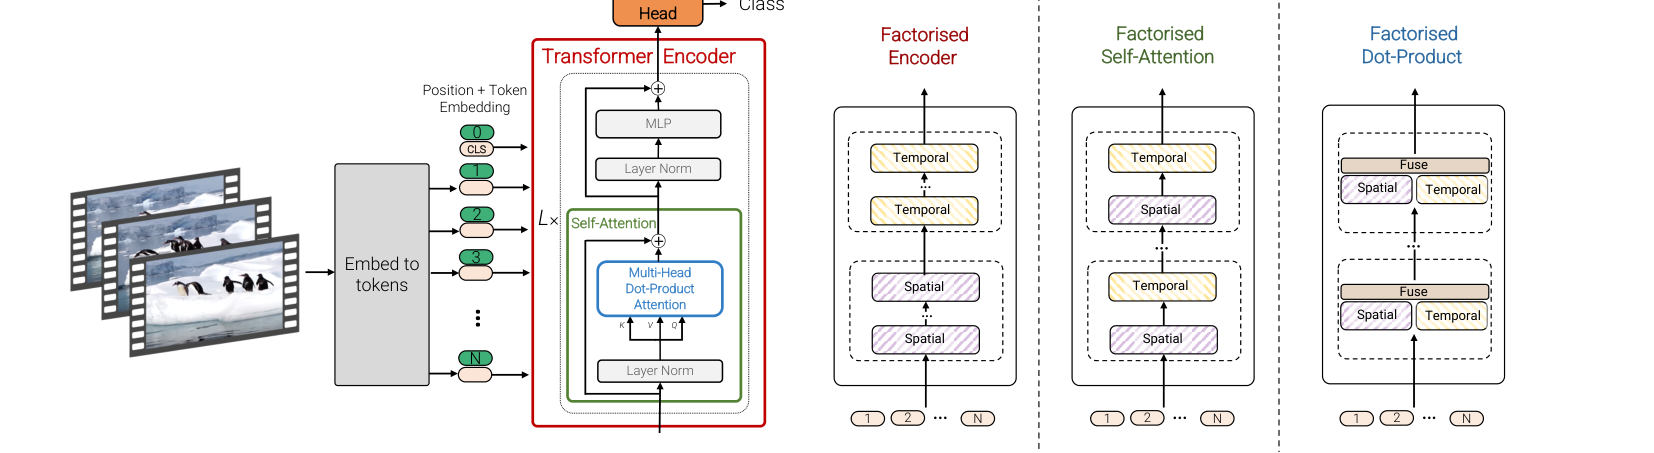
图 6.6-2:ViViT 并列四种时空 Transformer 分解方式,展示视频 token 在早期架构中的处理选择。 出处:Anurag Arnab et al.,ViViT: A Video Vision Transformer(2021),Figure 1。
在自监督学习中,掩码自编码器(Masked Autoencoders, MAE)重构被遮挡图像块的像素 [He et al., 2022],VideoMAE 把高比例时空遮挡用于视频表征学习 [Tong et al., 2022]。V-JEPA 采用另一种取舍:不重构像素,而是预测目标编码器产生的特征。对水面波纹或树叶细节是否“无语义价值”取决于任务,因此这里把它作为设计动机,而不是由 MAE 或 VideoMAE 实验普遍证明的结论。
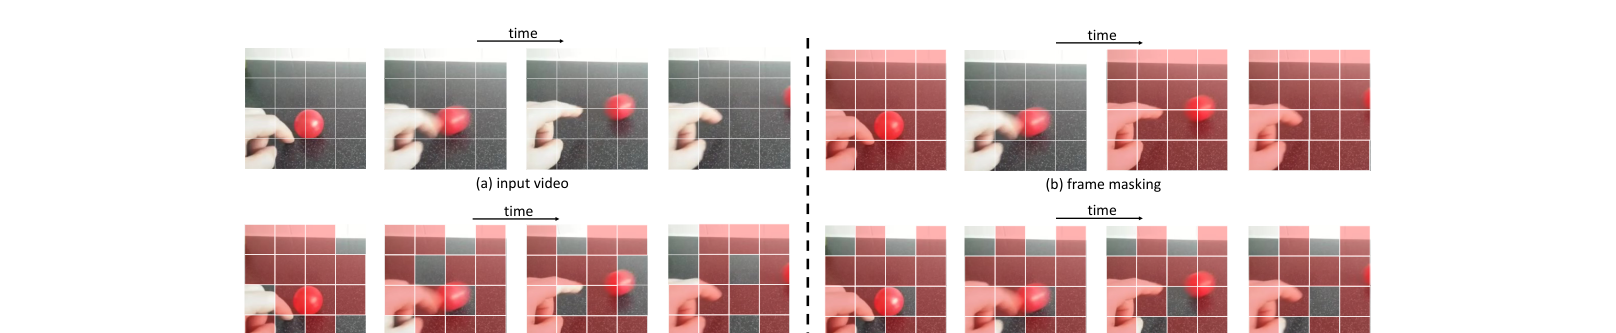
图 6.6-3:VideoMAE 的连续帧与管状掩码示例展示视频时间冗余为何允许高比例时空遮挡。 出处:Zhan Tong et al.,VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training(2022),Figure 2。
V-JEPA 不逐点重建被遮挡视频,而是预测目标编码器在对应时空位置产生的特征。论文通过冻结主干后的图像与视频评测检验表征质量;效率和泛化结论应限定在其报告的模型、数据与基线设置内。
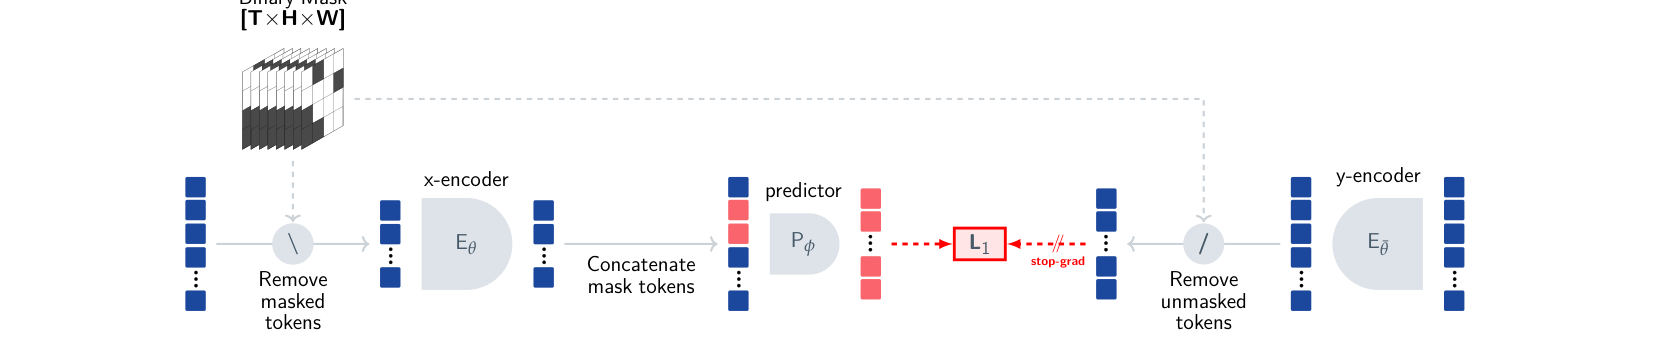
图 6.6-4:V-JEPA 原论文训练图串起视频 token、上下文编码器、EMA 目标编码器和位置条件预测器。 出处:Adrien Bardes et al.,Revisiting Feature Prediction for Learning Visual Representations from Video(2024),Figure 3。
从静态二维到动态三维:数据的降维解析
为了理解 V-JEPA 的输入机制,我们首先需要将视频这一复杂的多媒体形态,降维拆解为高中生即可理解的数学对象。
在初等几何中,我们知道一个平面可以由二维笛卡尔坐标系
视频只不过是在这个二维平面上增加了一个时间维度
在 V-JEPA 中,为了让 Transformer 能够处理这个庞大的三维张量,我们不能像早期的图像模型那样逐个像素地输入。我们需要将其“粗粒度化”。
设原始视频的时间帧数为
核心机制的数学推导与严格定义
V-JEPA 的核心思想是:给定视频的一个部分上下文(Context),预测该视频中被遮挡部分(Target)在隐空间中的特征表示。
1. 目标与上下文的严格划分
设完整的视频经过上述切分并线性映射后,表示为一个词元序列
2. 编码与隐空间映射
我们定义两个神经网络:上下文编码器(Context Encoder)
我们首先考察一个最简单的标量情形。假设输入只是单一的变量
同理,我们将目标序列
3. 位置条件预测
预测器(Predictor)
目标分支为什么变化较慢
上下文编码器和预测器接受当前损失的梯度,目标编码器则停止梯度,并用
4. 目标函数
预测损失比较目标位置上的预测特征
其中
核心网络架构与前向传播实现
在理解了严密的数学推导后,我们将使用 PyTorch 来构建这个系统的简洁版本。为了保持代码的教科书般的清晰,我们将分模块实现。
1. 时空分块与嵌入 (Tubelet Embedding)
首先,我们需要将输入的 4D 张量 (B, C, T, H, W) 转换为序列 (B, N, D)。我们通过 3D 卷积来实现这一时空切块和线性映射。
python
import torch
import torch.nn as nn
import torch.nn.functional as F
import copy

class TubeletEmbedding(nn.Module):
    """
    视频的时空分块与嵌入层。
    通过 3D 卷积将连续的时间和空间像素转化为离散的特征词元。
    """
    def __init__(self, in_channels=3, embed_dim=768, tubelet_size=(2, 16, 16)):
        super().__init__()
        # 使用 3D 卷积进行不重叠的滑动窗口提取,步长等于核大小
        self.proj = nn.Conv3d(
            in_channels=in_channels,
            out_channels=embed_dim,
            kernel_size=tubelet_size,
            stride=tubelet_size
        )

    def forward(self, x):
        # [执行 3D 卷积映射,将像素空间转为特征空间]
        # 输入维度: (B, C, T, H, W) -> 输出维度: (B, embed_dim, T', H', W')
        x = self.proj(x)
        # 展平空间和时间维度,准备输入 Transformer
        # (B, embed_dim, T', H', W') -> (B, embed_dim, N) -> (B, N, embed_dim)
        x = x.flatten(2).transpose(1, 2)
return x2. 三维位置编码 (3D Positional Encoding)
序列化本身不携带 token 的时空坐标,因此模型需要某种位置编码区分时间、行和列。这里使用可学习的绝对位置参数;它是教学选择,不意味着所有 V-JEPA 实现都必须采用同一种编码。
python
def get_3d_sincos_pos_embed(embed_dim, grid_size, t_size):
    """
    这是一个占位函数,说明 3D 位置编码的生成逻辑。
    出于简洁实现的目的,我们在主网络中将使用可学习的绝对位置参数代替。
    """
pass3. V-JEPA 主干网络 (V-JEPA Backbone)
V-JEPA 的主体由上下文编码器、目标编码器以及预测器组成。下面给出一个可独立运行的教学实现,并使用 PyTorch 自带的 TransformerEncoderLayer 组成基础 Transformer 块。
python
class VJEPAModel(nn.Module):
    def __init__(self,
                 img_size=224,
                 patch_size=16,
                 num_frames=16,
                 tubelet_size=2,
                 embed_dim=768,
                 depth=12,
                 num_heads=12,
                 predictor_embed_dim=384,
                 predictor_depth=6):
        super().__init__()

        # 1. 初始化时空嵌入层
        self.patch_embed = TubeletEmbedding(
            in_channels=3,
            embed_dim=embed_dim,
            tubelet_size=(tubelet_size, patch_size, patch_size)
        )

        # 计算序列总长度 N = (T / t) * (H / p) * (W / p)
        self.num_patches = (num_frames // tubelet_size) * ((img_size // patch_size) ** 2)

        # 2. 声明可学习的 3D 位置编码
        self.pos_embed = nn.Parameter(torch.zeros(1, self.num_patches, embed_dim), requires_grad=True)

        # 3. 构建上下文编码器 (学生)
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=embed_dim,
            nhead=num_heads,
            dim_feedforward=embed_dim * 4,
            batch_first=True,
            activation="gelu",
            norm_first=True
        )
        self.context_encoder = nn.TransformerEncoder(encoder_layer, num_layers=depth)

        # 4. 构建目标编码器 (导师),其结构与上下文编码器完全一致
        self.target_encoder = copy.deepcopy(self.context_encoder)
        # [锁定目标编码器的梯度,防止它被优化器直接更新]
        for param in self.target_encoder.parameters():
            param.requires_grad = False

        # 5. 构建预测器
        self.predictor_embed = nn.Linear(embed_dim, predictor_embed_dim)
        self.mask_token = nn.Parameter(torch.zeros(1, 1, predictor_embed_dim))
        self.predictor_pos_embed = nn.Parameter(torch.zeros(1, self.num_patches, predictor_embed_dim))

        predictor_layer = nn.TransformerEncoderLayer(
            d_model=predictor_embed_dim,
            nhead=num_heads // 2,
            dim_feedforward=predictor_embed_dim * 4,
            batch_first=True,
            activation="gelu",
            norm_first=True
        )
        self.predictor = nn.TransformerEncoder(predictor_layer, num_layers=predictor_depth)
        self.predictor_proj = nn.Linear(predictor_embed_dim, embed_dim)

    def update_target_encoder(self, momentum=0.996):
        """
        利用 EMA 缓慢更新目标编码器参数。
        """
        with torch.no_grad():
            for param_q, param_k in zip(self.context_encoder.parameters(), self.target_encoder.parameters()):
                param_k.mul_(momentum).add_(param_q, alpha=1.0 - momentum)

    def forward(self, x, context_mask, target_mask):
        """
        前向传播计算图
        参数:
            x: 原始视频张量 (B, 3, T, H, W)
            context_mask: 上下文部分的布尔掩码 (B, N)
            target_mask: 目标部分的布尔掩码 (B, N)
        """
        B = x.shape[0]
        context_counts = context_mask.sum(dim=1)
        target_counts = target_mask.sum(dim=1)
        if not torch.all(context_counts == context_counts[0]):
            raise ValueError("同一批次的每个样本必须选择相同数量的上下文 token。")
        if not torch.all(target_counts == target_counts[0]):
            raise ValueError("同一批次的每个样本必须选择相同数量的目标 token。")

        # 1. 时空块嵌入并加上位置编码
        x_embed = self.patch_embed(x) + self.pos_embed

        # 2. 目标特征提取 (仅用于产生 Ground Truth,不需要计算梯度)
        with torch.no_grad():
            # 获取完整的目标特征
            target_full_features = self.target_encoder(x_embed)
            # 通过 target_mask 筛选出真正的目标特征
            # 上面的显式检查保证布尔索引后可以安全恢复批量维。
            target_features = target_full_features[target_mask].view(B, -1, target_full_features.shape[-1])

        # 3. 上下文特征提取
        # 仅将未被遮挡的上下文送入编码器,这极大地节省了计算量
        context_x = x_embed[context_mask].view(B, -1, x_embed.shape[-1])
        context_features = self.context_encoder(context_x)

        # 4. 预测阶段
        # 降维以减少预测器的计算开销
        context_features = self.predictor_embed(context_features)

        # 构造预测器的输入:上下文特征 + 遮挡标志 (Mask Tokens)
        num_targets = target_features.shape[1]
        mask_tokens = self.mask_token.repeat(B, num_targets, 1)

        # [为需要预测的 Mask Token 注入它们本来对应的位置编码]
        # 这是 Predictor 能够知道“要预测哪里”的唯一途径
        target_pos_embed = self.predictor_pos_embed.repeat(B, 1, 1)[target_mask].view(B, -1, self.predictor_pos_embed.shape[-1])
        mask_tokens = mask_tokens + target_pos_embed

        # 拼接上下文与掩码,送入预测器
        predictor_input = torch.cat([context_features, mask_tokens], dim=1)
        predicted_features = self.predictor(predictor_input)

        # 提取对应于掩码部分的输出,并映射回原始维度
        predicted_target_features = predicted_features[:, -num_targets:]
        predicted_target_features = self.predictor_proj(predicted_target_features)

        # 5. 计算损失 (均方误差)
        loss = F.mse_loss(predicted_target_features, target_features)

        return loss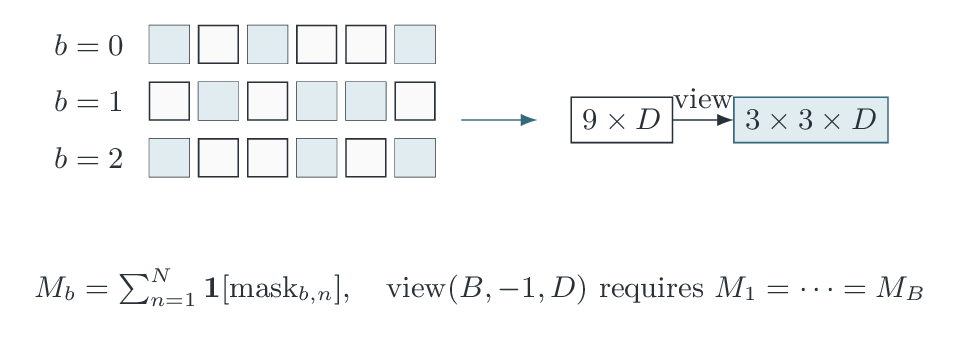
图 6.6-5:布尔索引先把所有选中 token 压成二维;只有每个 batch 的目标数 M_b 相同,才能无歧义地 view 为 B×M×D。本文根据上述代码的形状约束绘制
代码边界
在上述代码中,有几处为了与纯粹的数学推导对齐而设计的精密巧思值得读者反复推敲:
- 梯度的阻断:目标编码器的参数必须强制设为
requires_grad = False。模型唯一的学习信号来自于F.mse_loss反向传播给预测器和上下文编码器的梯度。 - 位置编码的时机:这个简化实现只在输入编码器前给上下文 token 加位置编码,并给
mask_token加目标位置编码。具体论文实现的编码位置与参数化应以官方代码为准。
结语
V-JEPA 把视频切成时空 token,只编码可见上下文,再预测被遮挡位置的目标表征。它展示了表征预测是一条有效的视频自监督路线,但不能据此断言像素重构普遍错误。理解实现时应分别检查掩码索引、位置条件、停止梯度与 EMA 更新。