
1.1 跑通 CartPole
本节代码:SB3 版本 · 纯 PyTorch 版本
本节我们完成第一个实验:跑通一次 CartPole 的 PPO 训练,观察奖励曲线的变化。
第一次训练
CartPole 是强化学习入门的经典任务。一根杆子通过关节连在小车上,控制器每步只能选择向左或向右推小车,目标是让杆子尽可能长时间保持竖直。
这个任务看起来简单,实现平衡却并不容易。杆子一旦开始倾斜,就会在重力作用下越倒越快;控制器必须抢在杆子倒下之前连续反向施力,而且每次只能全力向左或全力向右,没有中间力度可选。
训练它不需要任何特殊设备,普通笔记本 CPU 约 30 秒就能完成。
图 1-1:CartPole-v1 环境。智能体控制小车左右移动,使杆子保持竖直。图源:Gymnasium
如果希望逐单元查看代码,或者在终端里完整运行脚本,可以使用下面两种方式:
在线开发环境
↗启动 CPU 环境,拉取课程仓库后打开 notebooks/cartpole-ppo.ipynb,逐单元运行。
本地或云端终端
↗执行 python train.py --timesteps 30000。本地环境安装和运行流程见 1.3 节。
训练开始时,程序里的策略还是一张"白纸":它向左推和向右推的概率几乎各占一半,杆子平均撑 20 步左右就倒下了,奖励曲线在 20 分附近震荡。
随着训练推进,曲线逐步攀升,最终稳定在 500 分附近——这是环境的回合步数上限,意味着小车能撑满整个回合。
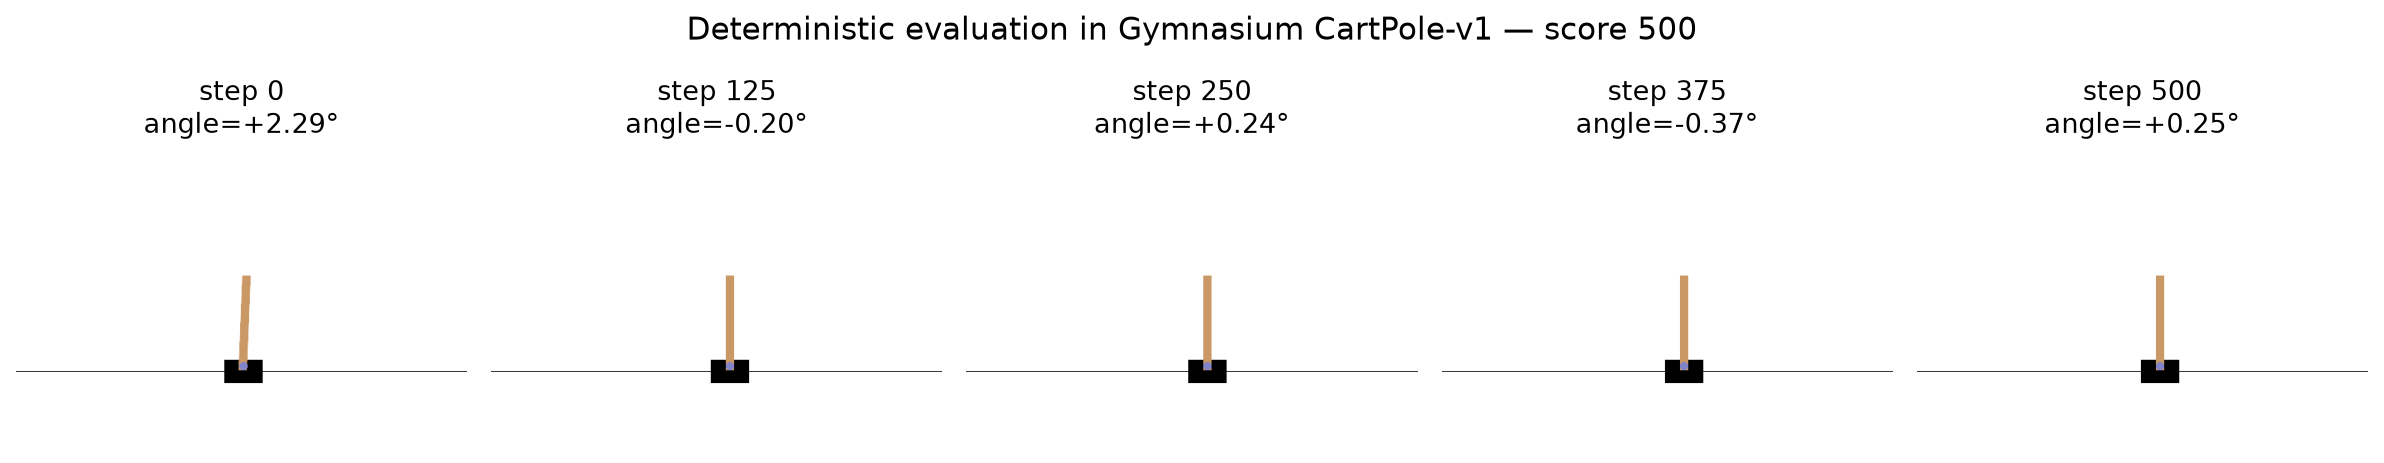
图 1-2:训练后策略在 CartPole-v1 中完成的一次评估,五帧来自同一回合的第 0、125、250、375 和 500 步。该回合撑满 500 步上限,说明策略能够持续控制小车。
到这里,训练已经跑通,学习现象也能观察到。它背后的机制——环境给智能体什么信息、智能体怎么做决策、PPO 怎样用一段交互数据改进策略——下一节再展开。