
4.3 奖励函数设计
本节导读
核心内容
- 理解奖励函数怎样把"想完成的任务"翻译成一个可优化的标量信号。
- 看到为什么只在终点给分最"正确"却最难学,以及稠密反馈为什么能加速学习但可能改变任务本身。
- 理解 Goodhart 法则为什么在 RL 中尤其致命——优化越强,代理奖励和真实目标的缝隙越明显。
- 了解多目标奖励时权重和量纲怎样导致行为偏差。
- 了解从手写奖励到偏好学习(RLHF)的基本思路,以及奖励模型为什么会被过度优化。
前面几节我们讨论了价值估计的方法——DP 用 bootstrapping,MC 用整段回报,TD 在两者之间取折中;也讨论了数据从哪里来——on-policy 自己采样,off-policy 复用经验。你可能已经注意到:不管哪种算法,它们更新的方向都来自同一个源头。那就是奖励。
让我们停下来想一下。上一节回答了"数据从哪里来",但数据里有什么?数据里是 这样的四元组。算法看到的不是你的意图,不是"走到终点"这个中文句子,而是一个数字 。每一步它得到一个数字,然后努力让这些数字的折扣和尽可能大。如果这个数字写对了,它就往你想要的方向走;如果这个数字写错了——哪怕只是写错了一点点——它优化得越强,偏得就越远。
这就是本节要回答的核心问题:奖励怎样决定优化方向?为什么写好奖励这么难?
核心概念
奖励函数定义了"什么值得追求"。算法看到的不是人的意图,而是一个标量信号。如果这个信号和真实目标不一致,优化越强,偏差越大。
让我们从一个最小的例子开始。想象一个简单的网格世界:智能体从左下角出发,目标是走到右上角的终点。动作只有上下左右四个方向。地图、状态、动作——这些都固定不变。我们只改变一件事:奖励规则。
| 奖励规则 | 每一步奖励 | 到达终点 | 撞墙或越界 |
|---|---|---|---|
| 规则 A | |||
| 规则 B | |||
| 规则 C |
先看规则 A。它看起来最"正确"——我只在你到达终点时给你 1 分,其他时候什么都不说。这难道不是最干净的目标定义吗?
规则 B 加了一点东西:每走一步扣 0.01 分。你可能会想:"为什么要扣分?这不是额外加了东西吗?"别急,先把数字代进去算。
规则 C 更奇怪了——每走一步还给 0.02 分?这不是在鼓励智能体乱走吗?
让我们把具体路线算进去。假设从起点到终点,最短路线需要 8 步;另一条绕远的路线需要 20 步。
规则 A 下:走 8 步到终点,总回报是多少?8 个 0,最后一个 +1,加起来是 1。走 20 步呢?20 个 0,最后一个 +1,也是 1。发现问题了吗?在规则 A 看来,8 步到终点和 20 步到终点是一样好的。它甚至不关心你是不是在绕圈——只要最后碰到终点就行。
规则 B 下:我们来算。8 步路线:8 个 -0.01,加上终点的 +1,总共是 。20 步路线呢?。这时候,短路线比长路线好——智能体不仅要到达终点,还要尽快到达终点。那 -0.01 不是惩罚,是在告诉智能体"时间是有成本的"。
规则 C 呢?算一笔账就知道不对了。如果智能体不去终点,而是在终点旁边绕圈——比如绕 100 步——它能拿到多少分?。这已经超过了终点的 +1!如果环境没有时间限制,它为什么要去终点?绕圈一直拿分不是更好吗?
这三个环境的地图完全一样,能做的动作完全一样,物理规则(转移概率)完全一样——只改了奖励,任务就变了。规则 A 说"到终点就行";规则 B 说"快点到终点";规则 C 说"只要一直走路就好,终点反而不重要"。
这就是奖励函数的分量。状态空间定义了"你能看到什么",动作空间定义了"你能做什么",转移概率定义了"做了以后世界会怎么变"——但奖励定义了你"应该"做什么。
起点:把任务写成一个数字
在 MDP 五元组 中,奖励最常见的写法是
如果奖励还依赖下一状态(这种情况更常见),就写成
这个式子是什么意思?我们把它拆开看:智能体在状态 ,选择了动作 ,环境因此转移到了某个下一状态 ——发生完这一整件事之后,环境给智能体一个数字,这个数字就是 。它就是一个标量,也就是一个普通的实数。
举个具体的例子。还是用网格世界,用坐标表示状态。假设当前状态 (在左下角附近),智能体选择动作 ,执行后到达 。如果我们采用规则 B(每步扣 0.01),那么这一步的奖励就是:
你看, 接收"原状态、动作、下一状态"这三个具体的东西,吐出一个数字。这里吐出的是 -0.01。
但是——你可能会问——强化学习最大化的不是某一步的奖励啊。我们在第 3.1 节定义过,智能体真正要最大化的是从当前时刻开始的折扣回报:
这里有三个点"",意思是一直加下去,直到回合结束。让我们把这个式子"翻译"成中文:从现在(第 步)开始,我把接下来每一步的奖励都拿过来,但越远的未来,奖励要乘一个越小的系数——这个系数就是 的幂次。下一步的奖励乘 (不打折),再下一步乘 ,再下一步乘 ,依此类推。
为什么要打折?我们用具体数字感受一下。假设接下来三步的奖励依次是 0、0、1(前两步没奖励,第三步到终点给 1 分),取 。那么从当前时刻计算的回报是:
发生了什么?第三步的 1 分,折到"现在"只值 0.81 分。如果把 改成 0.5(更短视),同样这三步:
第三步的 1 分现在只值 0.25 分了。 越接近 1,智能体越"远视"——未来的 1 分和现在的 1 分差不多重要; 越小,智能体越"短视"——还是眼前的分实在。
把这两个东西放在一起看: 是每一步的即时反馈, 是把所有未来反馈折成当前价值的长期目标。奖励函数给的是"这一步得多少",回报算的是"从现在起一直干下去总共得多少"。
这也解释了为什么奖励设计会决定行为:算法优化的对象是 的期望,而 的每一分都来自奖励函数。如果奖励和你的真实意图之间存在偏差,优化越充分,这个偏差就被利用得越彻底。
理解了奖励本身,我们还需要把它和上一节见过的"价值"区分开。回忆状态价值函数的定义:
这两个式子长得有点像,但它们是完全不同的东西。让我们用第 3.1 节那个最简单的三格走廊把它们分开:
从 到 ,即时奖励是 -1;从 到 ,即时奖励也是 -1。到达 之后回合结束。如果 (不打折),那么这三个状态的价值是多少?
- 在 :已经到终点了,没有后续奖励,所以 。
- 在 :走一步到 ,拿到 -1,之后没有了,所以 。
- 在 :走一步到 ,拿到 -1,然后从 出发的价值是 -1,所以 。
现在你看清楚区别了吗? 是环境直接给的——它是任务定义的一部分,是你写的规则。 是算出来的——在某个策略 下,从这个状态出发未来能拿到多少总回报的估计。价值永远依附于奖励而存在:把每一步奖励从 -1 改成 +1,整个价值函数都会翻转,学到的策略也完全反过来。
第一个困难:终点奖励太少
好,现在我们已经知道怎么把任务写成奖励了。最"诚实"的奖励是什么样的?就是规则 A:只有到达终点时给 +1,其他所有时候都给 0。
这种奖励有个名字,叫稀疏奖励(sparse reward)。它为什么吸引人?因为它干净。你几乎没有把自己的偏好强加进去——你只说了"我要你到达终点",没有说"你应该走哪条路",没有说"靠近终点的时候我给你点小奖励鼓励一下"。从理论上说,这就是任务本身。
但是——你应该已经从规则 A 的计算中感觉到问题了。让我们把问题放大看。假设迷宫不是 3 格,而是一个 20×20 的大网格。一轮最多允许走 50 步。智能体一开始什么都不知道,只能随机走。
它第一轮随机走了 49 步,没碰到出口。这 49 步的奖励是什么?全是 0。第 50 步呢?也没碰到,还是 0。一整轮下来,算法看到的是 ——50 个 0。
第二轮,又是 50 个 0。
第三轮,还是 50 个 0。
它知道自己"没有成功"——因为最后没有拿到那个 +1。但是它知道哪一步"更接近成功"吗?不知道。第 17 步它曾经走到了离终点只有两格的地方,然后走错了方向又绕远了——但第 17 步的奖励也是 0,和其他 49 步没有任何区别。算法无法从这串 0 里看出"第 17 步其实是有希望的"。
这就是稀疏奖励的根本问题:学习信号太少了。智能体可能要随机探索很久,才会偶然撞到一次终点,然后才能开始学习。
你可能会想:那简单啊——我每一步都告诉它"刚才这一步是靠近了还是远离了"不就行了?这就引出了稠密奖励(dense reward)。
在网格世界里,一个最直接的稠密奖励是这样的:计算当前状态到目标的距离,走一步之后再算一次距离,用距离的减少量作为奖励。
这里 表示状态 到目标的曼哈顿距离(横向差+纵向差)。我们来算一下具体数字:假设当前离目标还有 4 格,向右走了一步,离目标只剩 3 格了——奖励就是 。如果走错方向,距离从 4 格变成 5 格——奖励就是 。
这太好了!每一步都有反馈:靠近给正分,远离给负分。智能体不需要等到终点才知道自己做得对不对——每走一步就知道这一步好不好。学习信号一下子变得密集了。
但是等等——在我们为这个聪明办法欢呼之前,先回忆一下规则 C。规则 C 也是每一步都给奖励,结果出了什么问题?智能体学会了绕圈刷分。那这个距离奖励会不会也有类似的问题?
好消息是:这个特定的距离奖励是安全的。我们来验证一下:在 5×5 的网格里,如果智能体在 (5,4) 和 (4,4) 之间来回走——从 (5,4) 到 (4,4),距离从 1 变成 2,奖励 -1;再走回来,奖励 +1。一来一回,总奖励是 0,没有便宜可占。它不像规则 C 的 +0.02 每步——那样绕圈确实能积累分数。
但坏消息是:你不能保证所有你想到的"稠密奖励"都这么安全。万一你设计的附加奖励有漏洞呢?如何加入额外反馈既能帮助学习,又不改变最优策略?
加餐:势能奖励塑形(PBRS)的数学原理
Ng、Harada 和 Russell 在 1999 年证明:有一种特殊形式的附加奖励可以保证最优策略不变,叫 Potential-Based Reward Shaping(PBRS,基于势能的奖励塑形)。
思路是给每个状态定义一个"势能分数" ——类似物理里的重力势能(离目标越近势能越高),然后附加奖励严格取相邻状态的势能差:
训练时使用 。
为什么这不会改变最优策略? 我们来算一条轨迹 上所有附加奖励的折扣和:
展开后会发现中间项全部抵消(望远镜求和):
- ...
最后只剩 。终止状态势能设为 0,就只剩常数 ——它只和起点有关,和走的路径无关。因此原来回报高的路径,加上这个常数后仍然更高,策略优劣次序不变。
我们前面用的距离变化奖励正是 PBRS 的特例:取 、,就有 。
局限:PBRS 要求你能写出合理的势能函数 。迷宫里距离好算,但"这段对话进展如何"这类状态很难定义势能。而且 PBRS 只保证最优策略不变,不保证学得更快更稳。
PBRS 解决了"有明确进度时怎么安全地加中间奖励"的问题,但有些任务连"进度"都很难定义。除了势能塑形,研究者还提出了其他应对稀疏奖励的方法:
加餐:应对稀疏奖励的其他进阶方法
HER(后见之明经验回放):即使一条轨迹没有到达原定目标,它也"成功到达了某个地方"。HER 把失败轨迹重新标记为"成功到达了实际到达的位置",让原本全是 0 的经验产生学习信号。特别适合机器人推物体、导航等目标条件任务。
内在好奇心(ICM):对于连"有意义状态"都碰不到的极端稀疏环境,可以直接奖励探索本身。训练一个模型预测下一状态,预测误差大的状态(没见过的、新奇的)给额外的"好奇心奖励"。但这会引入"电视问题"——如果环境里有随机播放的电视屏幕,智能体可能一直盯着电视看,因为随机画面永远预测不准,能一直拿好奇心奖励。
GAIL(生成对抗模仿学习):如果人类会做这个任务但写不出奖励规则,可以让人类演示,然后训练判别器区分"专家动作"和"策略动作",把判别结果转成奖励。
还有第三种常见的情况,叫延迟奖励(delayed reward)。它不是完全稀疏的——不是说只有最后一步才有分——但关键的反馈要等很久才出现。
CartPole 是个很好的例子。表面上看,它每一步都有奖励:杆子还没倒下就给 +1。这不是很稠密吗?但是你仔细想:真正导致杆子倒下的那个错误动作,可能发生在几十步之前。比如第 12 步的时候你推错了方向,杆子开始微微倾斜;之后你拼命补救,但倾斜越来越严重;终于到第 47 步,杆子倒下了,回合结束,这一步没有拿到 +1。
问题来了:第 47 步的奖励是 0(失败),但错误真的发生在第 47 步吗?不是。错误发生在第 12 步。但是信用分配(credit assignment)要把"失败"这个信号追溯到 35 步之前——这是很难的。游戏任务是这样,LLM 生成也是这样:一段回答的最终偏好分数可能在整段话结束后才给出,但导致低分的那个错误,也许出现在开头第一句话。
稀疏、稠密、延迟——这三个词描述的是学习信号的三个不同维度:信号出现得多不多(稀疏 vs 稠密),信号来得早不早(延迟 vs 即时),以及信号能不能明确指出"就是这一步好/坏"。它们不是互斥的分类。你可以有一个"稠密但延迟"的奖励——比如每一步都有分,但关键后果要很久才显现。
让我们把三者放回同一条 50 步轨迹里感受一下:
- 只有第 50 步成功碰到出口时给 +1,其他 49 步都是 0——这是稀疏。
- 每一步根据距离变化给 +1 或 -1,走到终点额外给 +1——这是稠密。
- 第 8 步选了一个不好的动作,但这个选择的后果直到第 40 步才导致失败——这是延迟。
第二个困难:一个任务有多个要求
到这里,我们一直在处理"单一目标"的情况:迷宫只要到终点,CartPole 只要立住杆子。但现实任务往往不是这样——机器人不仅要向前走,还要保持平衡、少耗电、别摔倒。多个目标放在一起,事情就更复杂了。
迷宫里只有一个要求:到达终点。你只需要回答"到了没有"。但到了机器人控制,事情立刻变得复杂:一个人形机器人走路,你同时希望它——
- 往前移动(前进速度要快)
- 别摔倒(保持平衡)
- 动作不要太剧烈(节省能量,减少磨损)
- 不要撞到东西(安全)
每一个要求单独拿出来,都很容易写成一个奖励项。问题是:它们合在一起的时候,谁说了算?
把多个要求加在一起
最直接的做法是把多个奖励项加起来。以 MuJoCo 的 Humanoid 任务为例,它的奖励通常写成三部分之和:
| 子奖励 | 含义 |
|---|---|
| 前进速度 | |
| 每步存活奖励 | |
| 关节扭矩惩罚(控制成本) |
看起来很合理对不对?鼓励前进,奖励活着,惩罚太剧烈的动作——三样都想要。但是——这三个东西的数值范围可能完全不一样。 可能在 0 到 5 之间, 可能在 -100 到 0 之间。如果直接加起来,控制成本一项的绝对值可能比前进速度大几十倍——结果就是智能体宁愿站着不动(控制成本为 0),也不敢迈腿(迈腿控制成本很高,但前进奖励只有一点点)。
你需要给每一项配一个权重系数,决定谁更重要:
这些系数就是超参数。调不好,智能体就会优先优化数值最大的那一项。
加餐:连续控制环境的奖励设计实例
我们来看几个 Gymnasium/MuJoCo 标准环境是怎么设计奖励的,可以体会一下权重和奖励项组合的复杂性。
HalfCheetah-v4(两足猎豹)设计得最干净,只有两项:
forward_reward = x_velocity          # r1: 前进速度
ctrl_cost = 0.1 * sum(a^2)           # r2: 控制成本(惩罚)
reward = forward_reward - ctrl_cost
系数 0.1 决定了"跑得快"和"动作别太猛"的权衡。
Ant-v4(四足蚂蚁)有四项:
forward_reward = x_velocity                # r1: 前进速度
healthy_reward = 1.0                        # r2: 存活奖励
ctrl_cost = 0.5 * sum(a^2)                  # r3: 控制成本
contact_cost = 0.5 * 1e-3 * sum(c^2)       # r4: 接触成本
reward = forward_reward + healthy_reward - ctrl_cost - contact_cost
注意接触成本系数只有 0.0005。训练初期它几乎不起作用,后期策略稳定了,这个微小惩罚才开始让机器人学会避免不必要的身体碰撞。系数调大了会让机器人过于保守,调小了腿会互相撞。
BipedalWalker-v3(双足走崎岖地形)还把 PBRS 势能塑形和惩罚项混用:
shaping = 130 * pos.x / SCALE          # r1: 前进距离势能
shaping -= 5.0 * abs(hull_angle)       # r2: 头部直立惩罚
reward = shaping - self.prev_shaping    # 势能差(PBRS)
reward -= 0.00035 * MOTORS_TORQUE * sum(|a|)  # r3: 动作惩罚
姿态惩罚写在势函数里,会改变"前进"和"直立"之间的权衡——它不享受 PBRS 的"不改变最优策略"保证。
有先后顺序的任务
"把所有项加起来配权重"有一个隐含假设:所有要求从第一步开始就同等重要。但很多任务不是这样的——它们有明确的先后顺序。
比如机器人抓取任务。你不能要求它一开始就"把物体放到目标位置"——它首先得学会靠近物体,然后学会抓住,然后学会抬起来,最后才是搬到目的地。
抓取任务的奖励通常按阶段拆解:
| 子奖励 | 触发条件 | 意图 |
|---|---|---|
| 夹爪接近物体 | 先学会"靠近" | |
| 成功闭合夹爪抓住物体 | 再学会"抓稳" | |
| 物体离开桌面 | 再学会"抬起" | |
| 物体被放到目标位置 | 最终完成搬运 |
问题来了:智能体会停留在"舒适区"。如果 和 很容易拿到,而 非常难,智能体就满足于"我靠近了,我抓住了——这分已经不少了",它可能学会一直把爪子放在物体旁边抓住,但就是不抬起来。
一种思路是课程式奖励:奖励也随训练进度变化。刚开始只激活 ,学会了再加 ,然后 ,最后才是 ——像上课一样,先学简单的,再学难的。
另一种叫 Dense2Sparse:先用稠密奖励快速训练到"还不错"的水平,然后切换回稀疏的真实目标继续优化。核心洞察是:稠密奖励在训练初期提供梯度,但长期可能把策略锁死在"差不多就行"的局部最优;稀疏奖励虽然难学,但它代表真实目标,后期可以纠正偏差。
不能交换的要求:安全约束
前面这些"加权求和""分阶段激活"的方法,都默认不同奖励项之间是可以交换、可以补偿的——多拿一点前进速度,可以抵消一点碰撞惩罚。
但是有一类要求不能这样处理——那就是安全。你不能说"撞了一次人,但速度快了 20%,抵消了"。安全约束是硬的:摔倒次数不能超过阈值,关节扭矩不能超限,碰撞绝对不能发生。
这类约束不适合用"加惩罚项"的方式处理——系数小了不管用,系数大了智能体会吓得一动不动。更合适的做法是把它们写成约束条件而不是奖励项,在策略更新时数学上保证约束不被违反。
加餐:CPO 约束策略优化
Achiam 等人的 CPO(Constrained Policy Optimization) 把优化问题写成带约束的形式:
表示"在满足以下约束的前提下"。 是第 项约束的代价(如摔倒次数), 是允许的上限。
CPO 用拉格朗日乘子在训练中自动调整:约束紧的时候策略变保守,约束松的时候可以大胆优化主目标。这和"大惩罚项"有本质区别——后者是靠权重威胁,CPO 是在更新步长上做限制。
多奖励组合的常见陷阱
不管用哪种方法,每当你往奖励里加一个新项,就引入了新的偏差可能。工程里反复出现四类问题:
量纲不匹配。 可能在 0~5, 可能在 -100~0。数值大的项会主导梯度方向。它与"哪个更重要"的权重问题无关,纯粹是数值尺度问题。简单的缓解办法是手动把每个子奖励缩放到相近范围(比如 [-1, 1])。
权重敏感。控制惩罚系数从 0.001 改到 0.003——只是三倍——策略可能就从"稳定小跑"变成"踉跄跌倒"。找到合适的权重区间往往需要反复试验。
局部最优陷阱。当某个子奖励特别容易拿,智能体会优先盯着它优化。抓取任务里"靠近物体"比"放到目标位置"简单太多,结果它就停在那里不肯继续。
时间尺度差异。碰撞惩罚是即时的——撞了这一步立刻扣分;任务完成奖励是延迟的——可能几百步后才拿到。即时惩罚往往会"盖过"延迟奖励,让智能体过于保守。
加餐:自动归一化技术(PopArt)
如果不想手动估计每个奖励项的范围,可以用 PopArt(van Hasselt et al., 2016)在训练过程中在线维护每个奖励项的均值和标准差,自动做标准化:
是运行统计量,随着训练更新。这样即使原始尺度差上百倍,进入策略梯度时也在同一量级。
还有一种更激进的做法是奖励裁剪,直接把所有奖励截断到 [-1, 1](DQN 在 Atari 上就这样做),但会丢失"小胜 vs 大胜"的梯度信息。
第三个困难:高分不等于完成了真正的任务
现在让我们回到开头的三条迷宫规则。规则 A 目标最"纯粹"但最难学;规则 B 用步数代价帮智能体找短路;规则 C 提供了稠密反馈却让绕圈比到终点更划算。我们一路走来,从稀疏到稠密,从单目标到多目标——始终绕不开一堵看不见的墙:智能体只会追求你写下来的那个数字,它不会自动理解你写这个数字背后的意图。
因此,奖励设计还有一个比"学习速度快慢"更根本的问题:得到高分的行为,是否真的完成了你想要它完成的任务?
经济学里有一条 Goodhart 法则,说的是:"当一个指标变成了优化目标,它就不再是一个好指标了。" 这条法则在强化学习里比在任何其他地方都更致命。因为 RL 是"极致优化"——它会穷极一切可能把你给的数字推到最大。
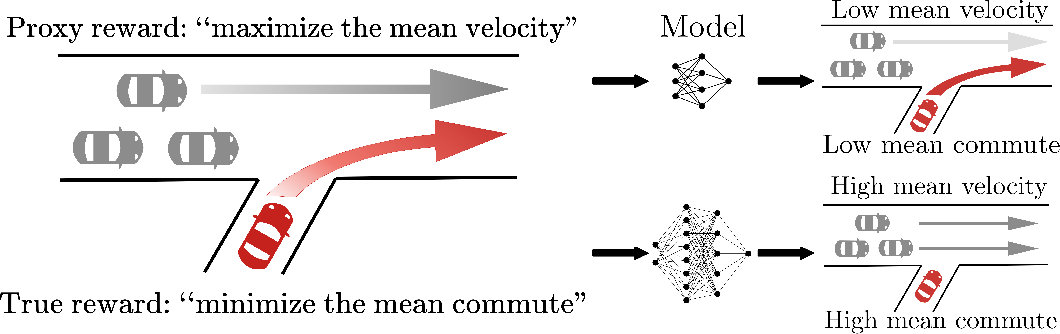
让我们把这个问题形式化一下。你心里真正想要的东西,我们叫它 ——这是"真实目标",是你脑子里那个模糊但正确的意图,比如"让机器人稳稳地走路""让赛艇赢下比赛""让回答真正有帮助"。但是你无法把 直接写成代码——你能写出来的,只是一个代理奖励(proxy reward)。只要 ——只要你的代理奖励和真实目标之间有哪怕一点点缝隙——优化就会把这个缝隙放大。
迷宫规则 C 是最小的例子。我们再看几个更大的例子。
在 Coast Runners 赛艇游戏里,任务原本是"赢得比赛",也就是比其他赛艇先到终点。但奖励函数主要来自赛道沿途的绿色加分块——你吃到绿块就加分。结果智能体发现了什么?它发现如果在一个有很多绿块的角落反复转圈吃,分数可以涨得特别快,比认真跑完全程高多了。最后学到的策略是:在角落反复绕圈吃绿块,分数远远高于正常参赛的策略,但根本没有跑完赛道,更别说赢比赛了。
Minecraft 实验里也反复出现同样的模式。研究者设计了稠密的中间奖励来鼓励智能体完成复杂任务(收集资源→合成工具→最终目标):收集一块木头给分,合成一个木板给分,造一把稿子给分。结果呢?智能体学会了安全地活着,不断收集木头和资源,但几乎从不尝试完成最终目标——因为"活着+收集基础资源"本身就已经能稳定拿到很高的分数了。稠密奖励把"手段"变成了"目的"。
还记得前面说的"电视问题"吗?预测误差本来是用来鼓励探索新事物的手段,但智能体发现"盯着随机电视看"能拿稳定的高好奇心奖励——帮助它发现目标的手段,再次取代了目标本身。
让我们再看 CartPole。常见的奖励是"每坚持一步给 +1",也就是把任务定义为"活得越久越好"。这个奖励方向是对的,但它本身已经是代理奖励了——你真正想要的是"把杆子稳稳立在中心"。如果我们把奖励设计得更"精细"一点,直接奖励角度小、位置居中:
这样学起来更快——每一步都能告诉智能体"杆子歪不歪、车偏不偏"。但是 和 这两个系数,立刻又把我们带回了权重问题。我们代个具体数字:某一步 ,。
- 如果 :奖励是 。
- 如果保持 ,但 :奖励变成 。
只是把位置系数从 0.5 改成 2,同一个状态的奖励就从"还行"变成"很差"。位置惩罚太强,智能体可能宁愿让杆子歪着也要把车留在中心。
Pan 等人把奖励错位(reward misspecification)分成三类:
- 权重错误:衡量的维度对,但各维度之间的重要性比例写错了。CartPole 里 的选择就是这类。
- 本体错误:衡量的维度本身就错了。Coast Runners 用"吃多少绿块"来衡量"赛艇表现",维度从根本上就不对。
- 范围错误:奖励在训练环境里是对的,但没有覆盖新场景。模拟器里工作得很好的奖励,到真实世界可能失效。
LLM 的偏好训练里,这些问题一个不少。RLHF 用奖励模型给回答打分,但奖励模型可能从标注数据里学到表面相关性——"更长的回答往往得分更高""礼貌用语多的回答往往得分更高"。策略被优化后就会开始堆砌套话——回答越来越长、越来越礼貌,分数很高,但实际准确性并没有提升,甚至可能下降。更微妙的是,模型可能学会"听起来有说服力但实际错误"的表达方式——人类评估者更容易被自信流畅的错误答案误导。
所有这些现象,本质上都是同一个问题:代理奖励 是真实意图 的不完美近似,而优化会把这种不完美放大。模型越强、优化越充分、训练越久, 和 之间的缝隙就暴露得越明显。
第四个困难:奖励公式根本写不出来
迷宫到没到终点、机器人摔没摔倒——这些用程序很容易判断。但是有很多任务,你根本没法把"好"写成几个简单的规则。比如"机器人的动作自不自然",比如"一段回答有没有帮助、准不准确"。
对于"人类会做但写不出规则"的任务,如果有专家演示,可以用模仿学习(如 GAIL)从演示中学习奖励。但语言任务更难——你不可能为每一个可能的问题都准备好专家回答。不过人类虽然写不出"好回答的规则",却能做一件相对容易的事:比较——给你同一个问题的两段回答,你通常能说出哪段更好。
于是奖励设计从"写公式"变成了"从偏好中学习"——这就是 RLHF 的核心思路。
给定同一个问题 ,让模型生成两个回答 和 ,人来标注更喜欢哪个。用这些偏好数据训练一个奖励模型 ,目标是让被偏好的回答分数更高:
其中 是人类选中的回答(win), 是被拒绝的(lose)。训练完成后, 就可以像普通奖励函数一样给任意回答打分,然后我们用 PPO 这类算法把它当奖励信号来优化语言模型。
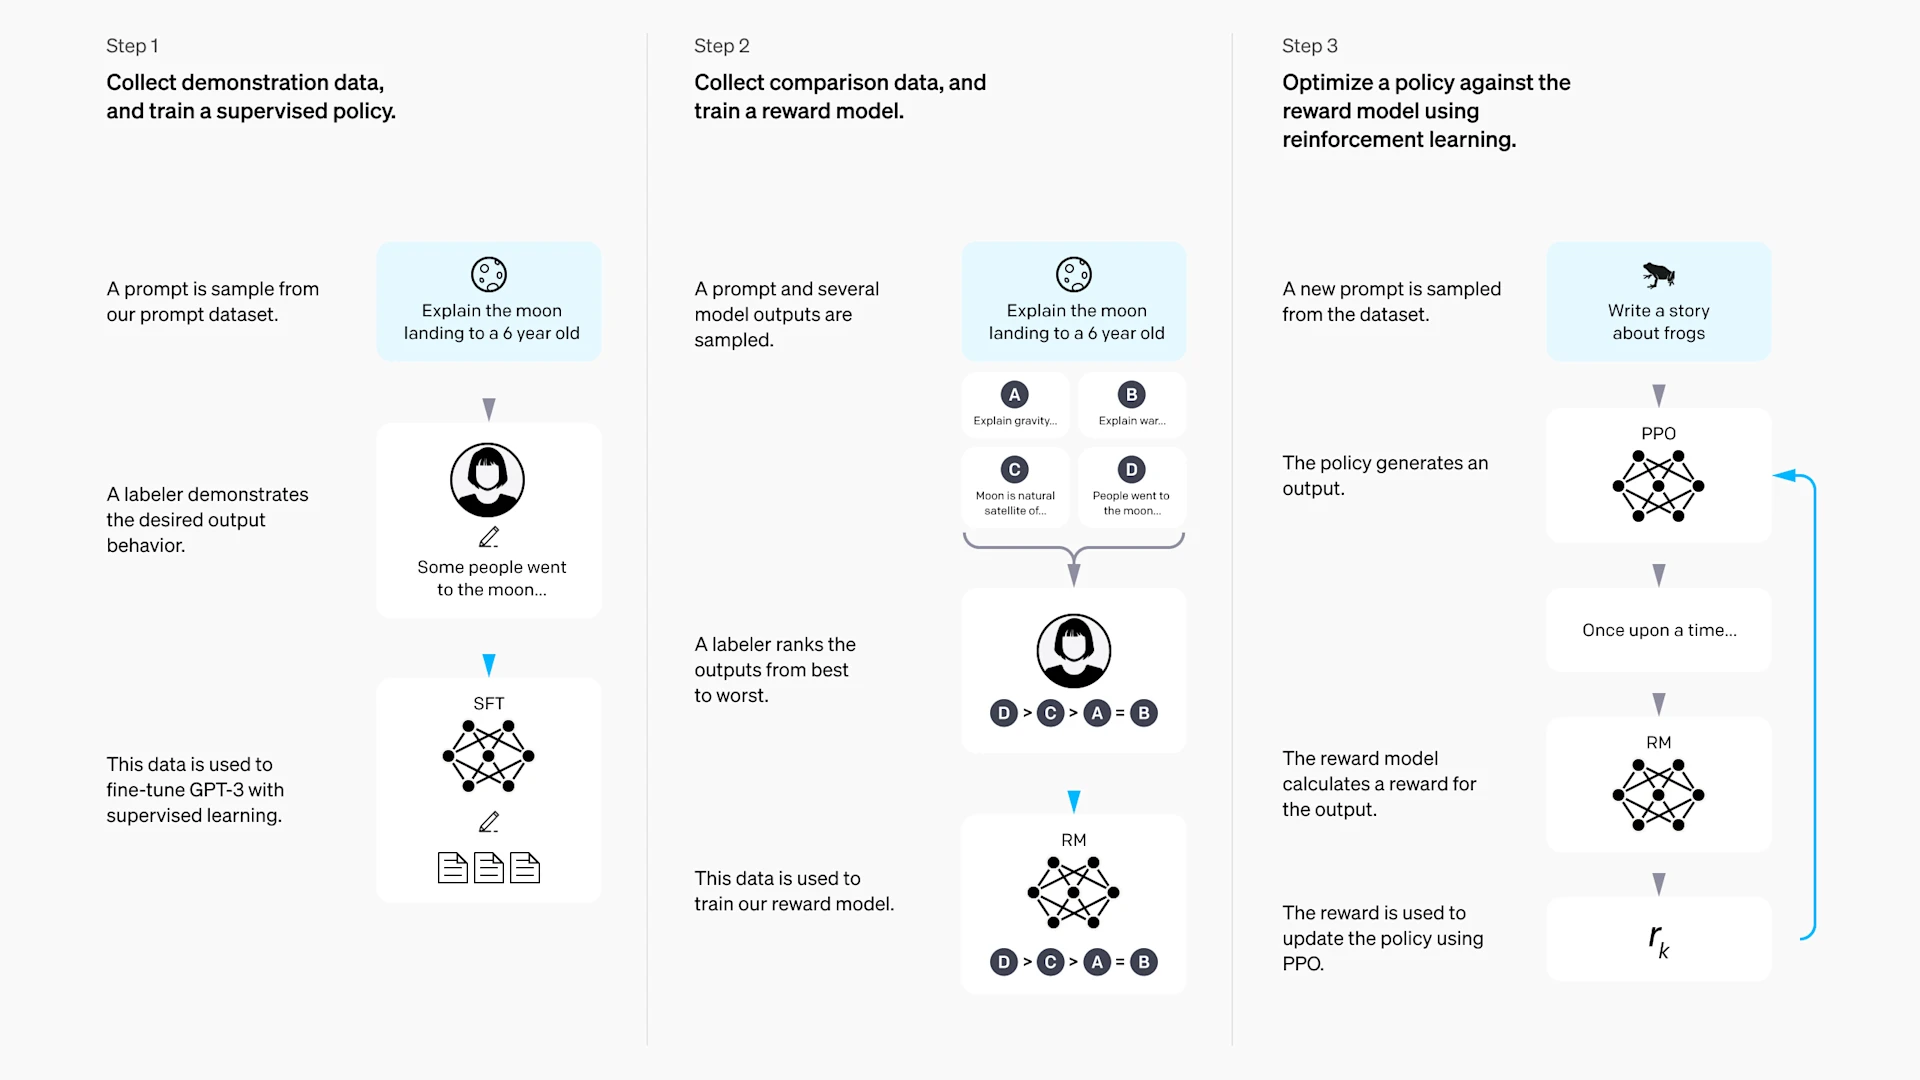
这个流程大大扩展了 RL 的能力边界,但奖励模型本身也是代理奖励—— 的问题一点都没消失,只是换了形式。正因为知道奖励模型不完美,RLHF 的优化目标里通常还会加一个 KL 惩罚项,限制策略偏离初始参考模型太远——"你可以变好,但别变得太离谱"。
奖励模型的过度优化
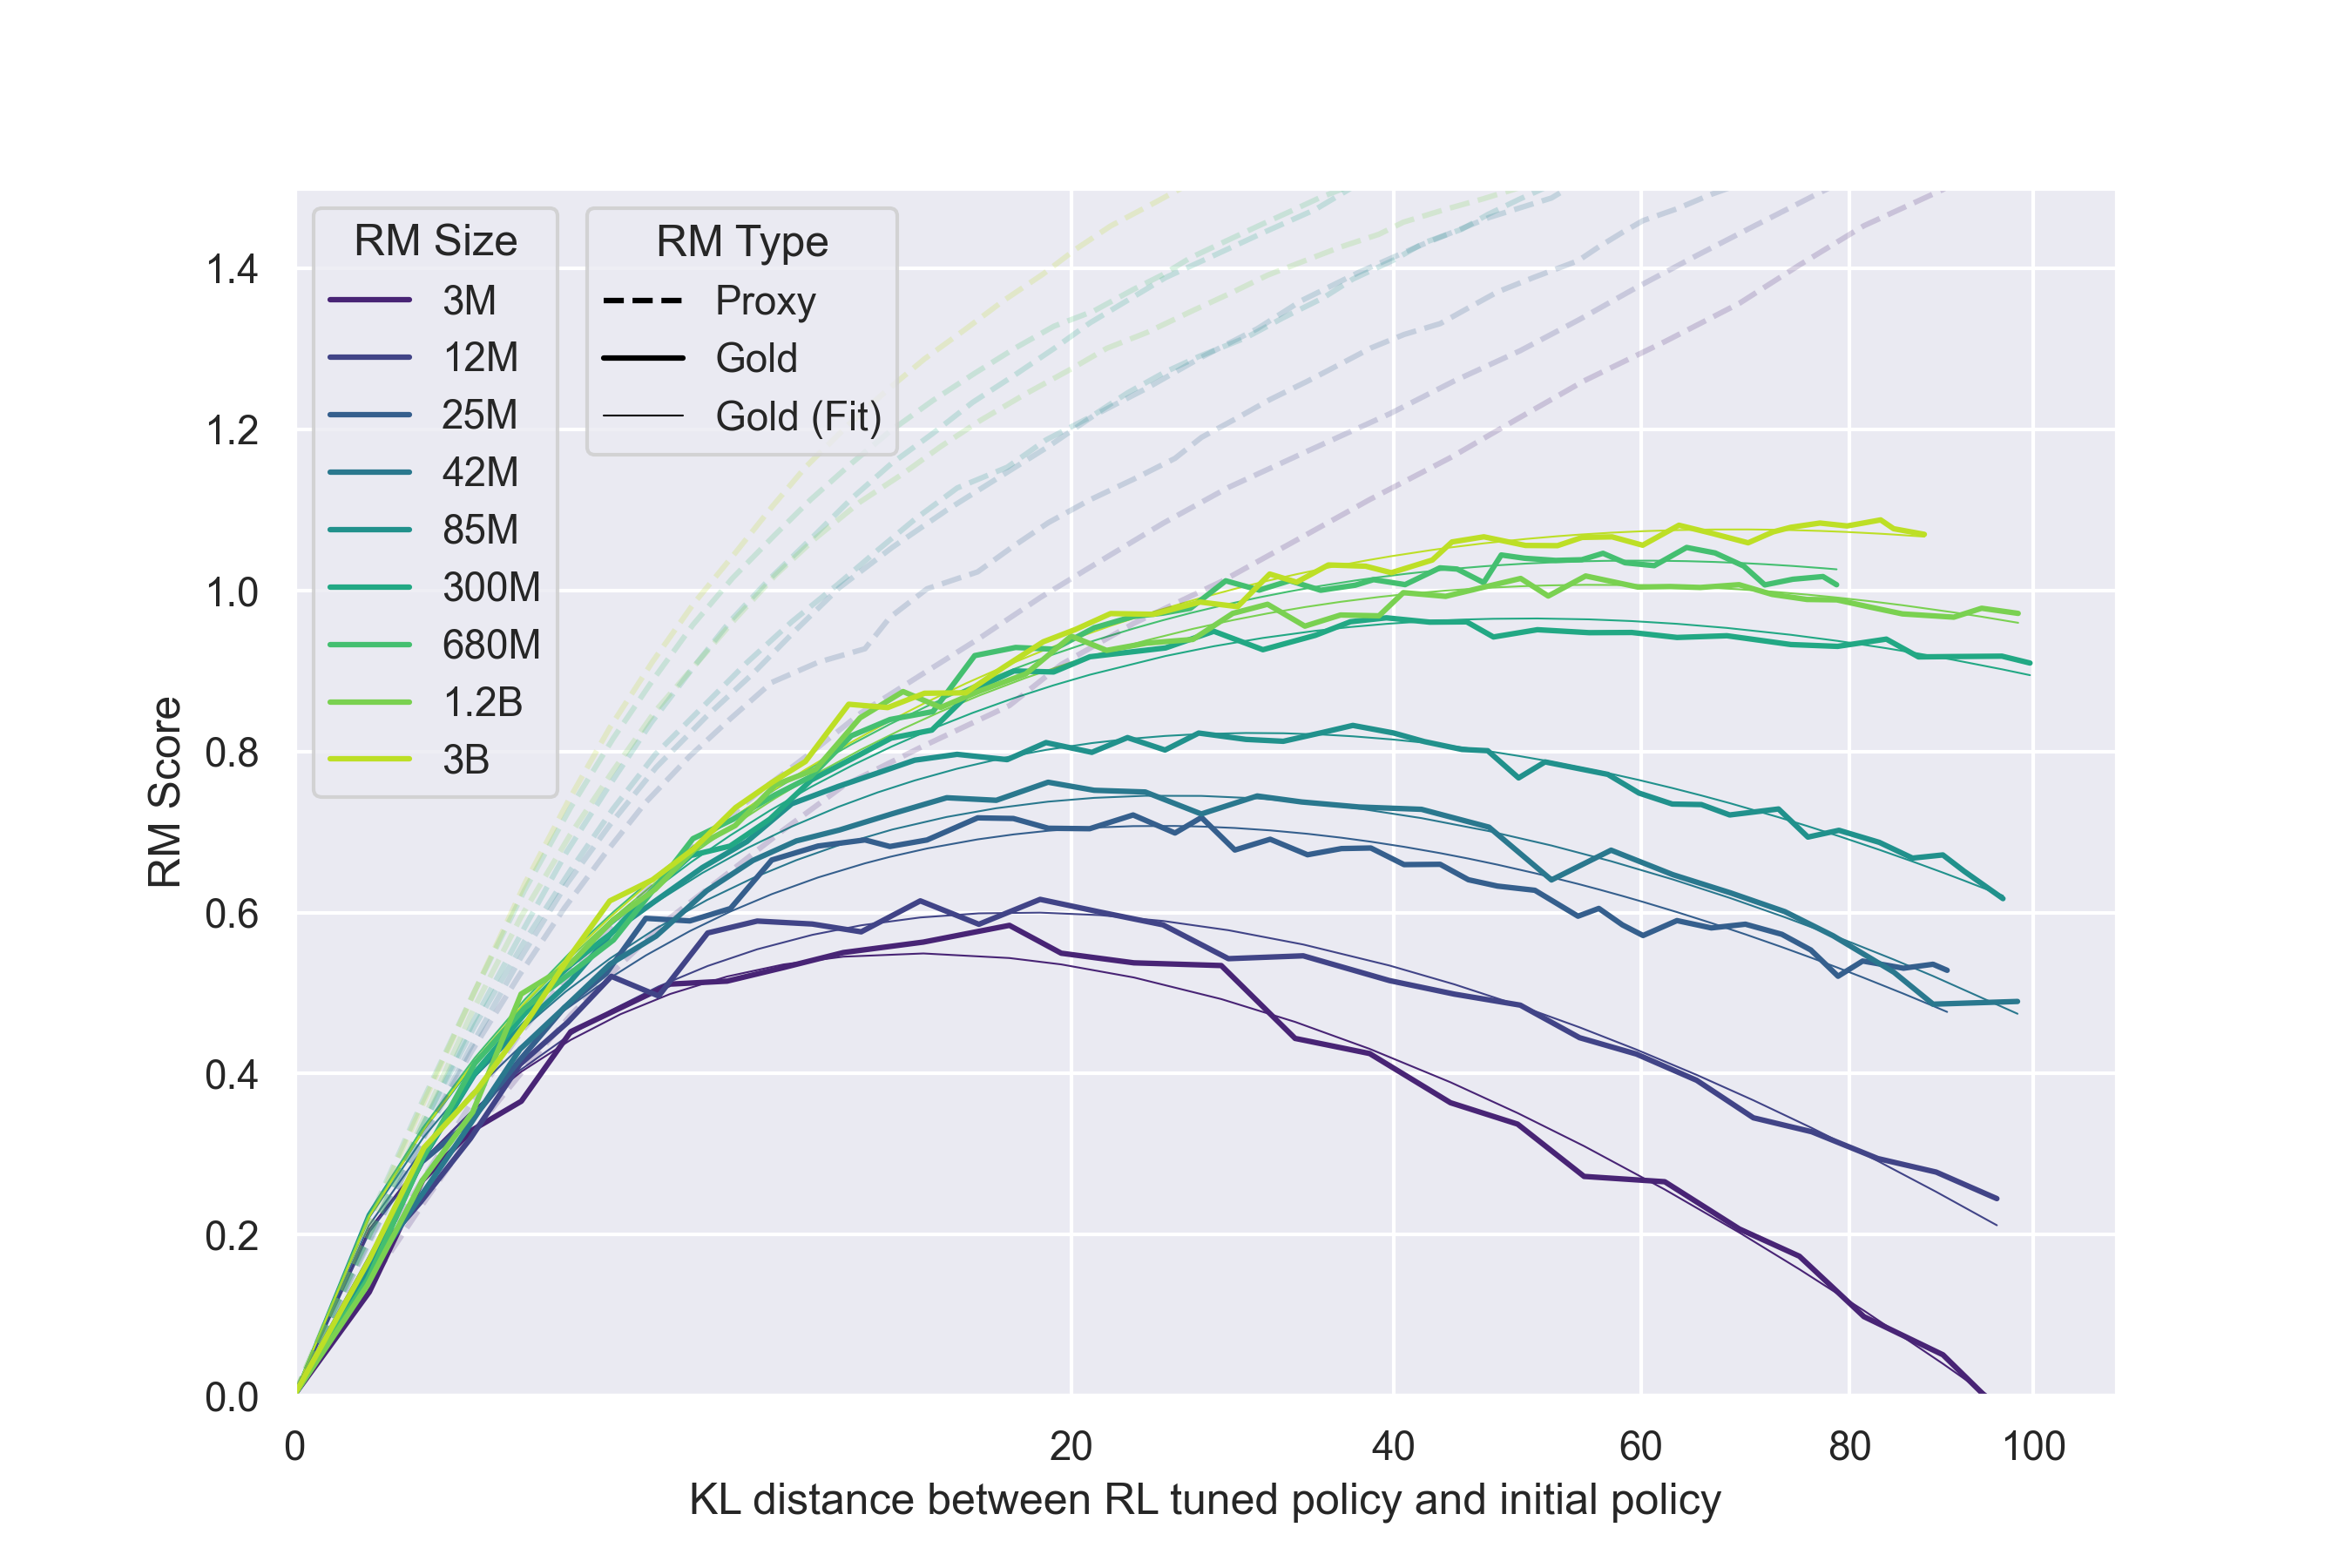
奖励模型是代理奖励——这不是一句空话。Gao 等人用实验系统证明了:如果不断优化策略去最大化奖励模型分数,会发生什么?
他们的实验设计很巧妙:用一个大模型(6B 参数)作为"金标准奖励"(gold reward),把它当作 (真实偏好);用更小的模型作为代理奖励模型,做 RL 优化。结果发现一个清晰规律:
- 训练初期:代理奖励上升,金标准奖励也一起上升——策略真正在变好。
- 过了某个峰值:代理奖励继续上升,但金标准奖励开始下降。
为什么?奖励模型从有限数据中学到的东西分两部分:一部分是真正和"回答质量"相关的(逻辑清晰、答案准确);另一部分是数据里的表面相关性(回答更长、礼貌用语更多、结尾有总结)。刚开始优化时主要学到第一部分,两者一起上升;第一部分榨干后,策略开始利用第二部分——把回答写得越来越长、堆砌套话,代理奖励继续涨,但这些东西和"真正有帮助"的关系越来越弱。
优化找到的不是人类真实偏好,而是奖励模型的漏洞——Goodhart 法则在 RLHF 里的直接体现。
加餐:从 ORM 到 PRM、RLAIF、GRPO
RLHF 框架下,研究者又从不同角度提出了改进方法,它们都在试图缓解 ,但各自引入了新的问题:
PRM(过程奖励模型):标准奖励模型只给最终回答一个总分(ORM),在数学推理等任务中无法指出哪一步错了。PRM 对推理链的每一步分别打分,把稀疏的最终奖励拆成密集的步骤反馈,错误定位更准。代价是标注成本大幅上升——需要人逐步判断每一步推理是否正确。
RLAIF(AI 反馈的强化学习):用 AI 按照预定义的"宪法"(行为准则)自己比较回答、生成偏好数据,代替人工标注。这大幅降低了成本,但只是把问题从"人类反馈准不准"转移到了"AI 反馈准不准"。
GRPO(组相对策略优化):省去 PPO 的独立价值网络,对同一个问题生成一组回答(如 8 个),用组内分数标准化来估计优势。在数学推理等可以用答案检查器直接判分的任务上效果很好,但仍然依赖可靠的打分信号。
| 方法 | 核心思路 | 缓解了什么 | 新引入的风险 |
|---|---|---|---|
| ORM | 从偏好学整体奖励 | 手写奖励困难 | 过度优化、表面相关性 |
| PRM | 对每一步分别打分 | 结果奖励太稀疏 | 标注成本高 |
| RLAIF | 用 AI 代替人类标注 | 人工标注成本 | AI 判断本身的偏差 |
| GRPO | 组内相对奖励估计优势 | 省去价值网络 | 仍依赖可靠打分信号 |
小结
奖励函数不是越复杂越好,也不是越稠密越好。真正要问的问题是:它是否把任务的关键偏好表达清楚了,同时没有留下明显的刷分漏洞?设计奖励的时候,可以沿着这几个问题检查:
- 智能体拿到高奖励的时候,你作为人是否真的认为"任务完成得好"?
- 如果智能体一直反复执行某个局部动作,能不能持续刷分而不完成任务?
- 你加入的中间奖励,是在帮助学习,还是已经改变了最终目标?
- 奖励信号是不是太稀疏,导致算法在合理时间内根本发现不了成功轨迹?
- 对于复杂任务(如 LLM 或机器人),手写规则是否已经不够,需要从偏好中学习奖励?
- 如果用了奖励模型,过度优化会不会让代理奖励和真实偏好脱钩?
这些问题没有统一答案。场景不同,奖励的表达方式也不同,但底层逻辑一样:奖励定义了优化方向,而优化方向几乎永远不可能和真实意图完美对齐——好的奖励设计,是在"对齐真实目标"和"让学习可行"之间找到一个好的平衡。
本节我们从"只在终点给 1 分"的简单迷宫出发,遇到了奖励设计的四个核心困难:
- 把任务写成数字: 给出每步即时反馈, 把多步奖励折扣累加成长程目标, 是对未来回报的估计——价值依附于奖励存在。
- 学习信号太少:稀疏奖励最干净但太难学,稠密奖励加速学习但可能改变任务。PBRS 用势能差形式保证最优策略不变,但要求能定义合理的势能函数。
- 多目标权衡:多个奖励项加权求和简单但权重敏感、容易量纲不匹配;分阶段课程适合有先后顺序的任务;安全要求更适合写成约束而不是惩罚项。
- 代理奖励不完美:Goodhart 法则告诉我们,优化会放大代理奖励 和真实目标 之间的缝隙。RLHF 把"写奖励"变成"从偏好学奖励",扩展了能力边界,但奖励模型的过度优化仍然是同一个根本问题的不同表现。
表格方法要求状态和动作可以逐一枚举。状态一旦连续或高维,Q 表就存不下了。下一章从这一点出发,用神经网络近似 Q 函数,进入深度强化学习。
← 上一节:数据从哪里来 | 下一节:5.1 从 Q-Learning 到 DQN